AI 雙面刃下的資安攻防戰:後 AI 時代的四大資安挑戰與 SASE 解方
隨著生成式 AI 與 AI 代理(AI Agent)在企業中廣泛部署,資安攻防的型態正在發生結構性轉變。本文從攻擊端、使用端、應用端與管理端四個維度,深入剖析後 AI 時代企業所面臨的新型態資安挑戰,並探討企業如何透過原生融合網路與安全架構,重新建構堅實的縱深防禦體系。
AI 浪潮背後的「新攻擊面」
近年來,AI 無疑是市場上最熱門的焦點。員工用它撰寫郵件與程式碼,企業將大型語言模型(Large Language Model, LLM)嵌入客服與知識庫,甚至讓 AI Agent 自主呼叫工具完成工作。然而,同樣的能力也正落在攻擊者手中。根據 IBM《2025 年資料外洩成本報告》,已有 16% 的資料外洩事件涉及攻擊者使用 AI,另有 13% 的組織回報其 AI 模型或應用遭到入侵。在後 AI 時代(AI 已深入企業日常運作的新常態),攻防雙方都握有 AI,資安的關鍵已不只是擋下攻擊,而是能否即時看見異常並迅速反應。
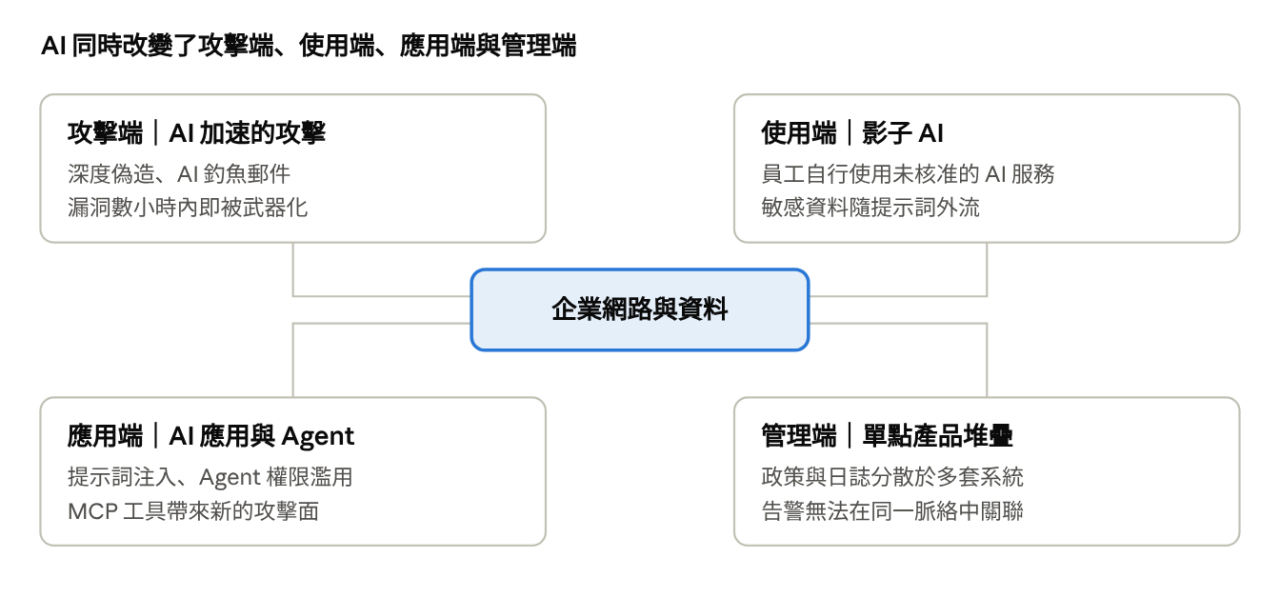 圖一:後 AI 時代企業面臨的四大資安挑戰,分別來自攻擊端、使用端、應用端與管理端。
AI 加速的攻擊:被壓縮到極限的防禦時間
過去從發現未知漏洞(Zero-day)到撰寫出可用的漏洞利用程式(Exploit),往往需要頂尖駭客耗費數週進行逆向工程;如今,具備自主推理與工具呼叫能力的 AI Agent 已能將這個過程壓縮至數小時甚至數分鐘。前沿研究與實戰案例已證實,AI Agent 能自主分析開源專案、定位潛在的零日漏洞,並在無需人類干預的情況下,自動完成「偵察掃描、生成 Exploit、橫向移動到外傳資料」的完整攻擊鏈。同時,一旦新漏洞(CVE)公開,攻擊端的 AI 也能在數小時內將其武器化並對全球目標發動無差別掃描,讓傳統以「月」為單位的修補節奏徹底失效。Anthropic 於 2025 年 11 月揭露的國家級網路間諜行動中,便有高達 80–90% 的攻擊操作是由 AI 自主執行。當攻擊端已進化為全自動、可同時對數千個目標展開的 AI Agent,仰賴人工逐一分析告警的防禦模式勢必無法招架。
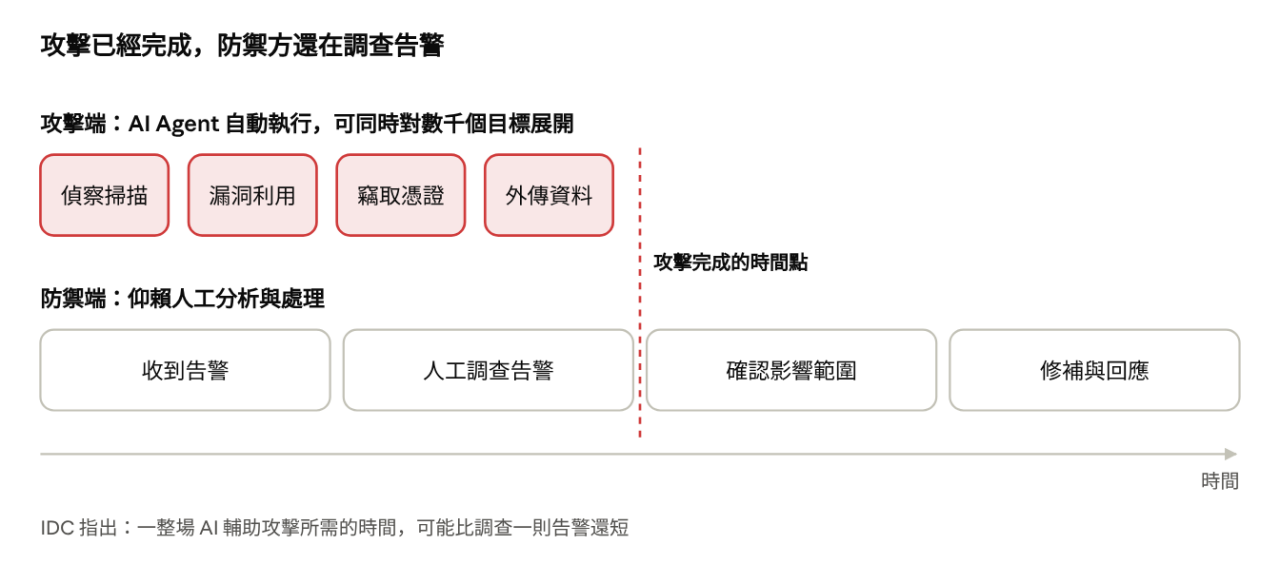 圖二:AI 輔助攻擊與人工防禦的速度落差,當攻擊完成時,防禦方往往仍在調查第一則告警。
影子 AI(Shadow AI):看不見的資料外洩管道
影子 AI 指的是員工未經核准、自行使用的 AI 服務。員工為了效率,將合約、客戶名單或原始碼貼入公用 AI,這些資料一旦離開企業邊界,就可能被保留、用於模型訓練,或因服務商的資安事件而外洩。IBM 報告指出,每五家組織就有一家曾因影子 AI 發生資料外洩,且在因 AI 而遭入侵的組織中,有 97% 未建立適當的存取控制。
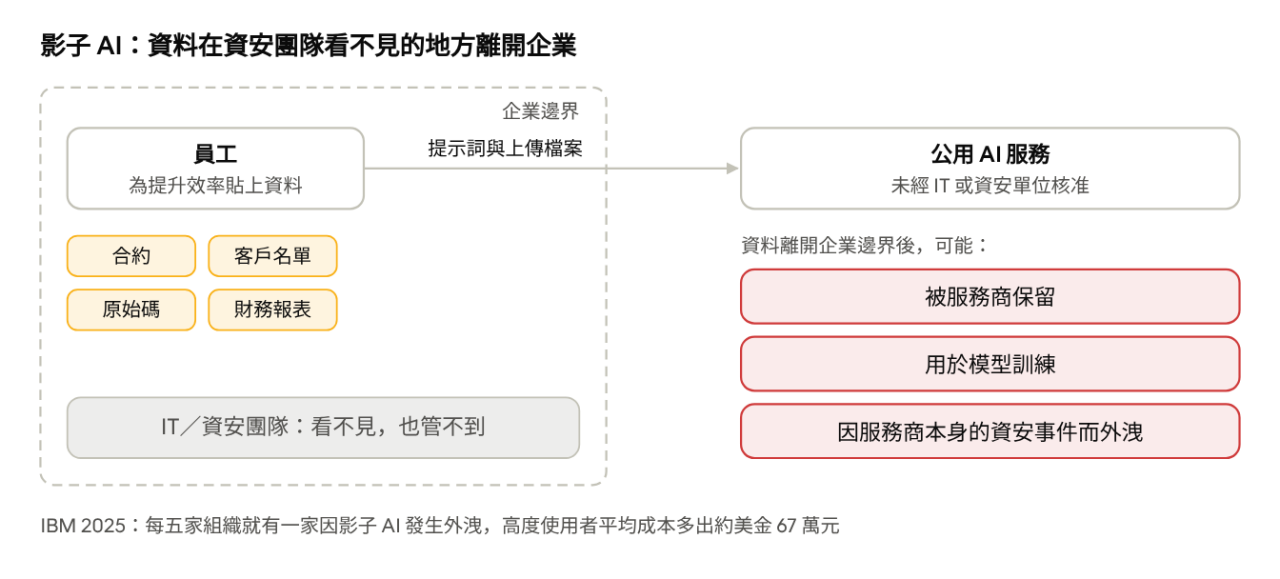 圖三:影子 AI 的資料外洩路徑示意圖,敏感資料隨提示詞離開企業邊界,資安團隊卻無法察覺。
傳統網址過濾(URL Filtering)只能全面封鎖或全面放行,前者逼使員工改用個人裝置,後者等同放任資料外流。企業真正需要的,是看見員工使用哪些 AI 服務、依風險控制可執行的動作,並在提示詞(Prompt)送出前即時檢查敏感資料。
AI 應用與 AI Agent 本身成為攻擊目標
當企業將 LLM 接上知識庫與業務系統,AI 就從「工具」變成「擁有權限的使用者」,攻擊者只要能影響它讀取的內容,就能影響它的行為。OWASP 將提示詞注入(Prompt Injection)列為 LLM 應用十大風險之首,其中間接注入(Indirect Injection)會將指令藏在網頁、文件或郵件中,待 AI 讀取時觸發。2025 年揭露的 EchoLeak(CVE-2025-32711)即是一例:攻擊者只需寄出一封特製郵件,就可能誘使 Microsoft 365 Copilot 外洩資料,受害者無需任何操作。
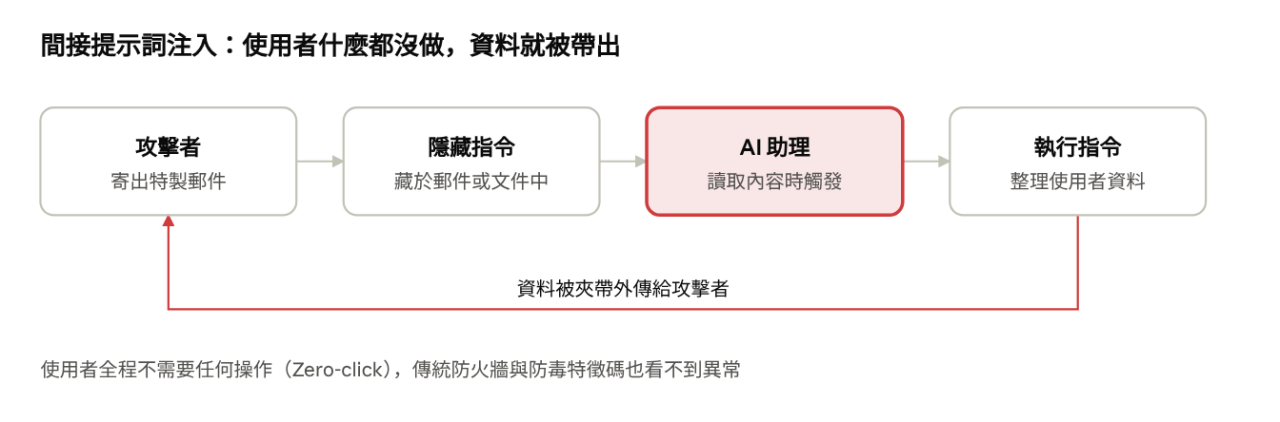 圖四:間接提示詞注入的攻擊流程示意圖,惡意指令隱藏於 AI 助理會讀取的內容中。
AI Agent 與模型上下文協定(Model Context Protocol, MCP)的普及,進一步放大了風險。每接上一個 MCP Server,就等於賦予 Agent 新的工具與權限,一旦 Agent 遭到注入,就能以合法身分刪改或外傳資料。這些攻擊發生在語意層,傳統防火牆與特徵碼無法理解一句「請忽略前述指令」的含意,但 AI 在讀取外部內容時,卻可能將這串惡意文字視為新的任務指令,轉而執行攻擊者暗藏的惡意指令。
單點產品堆疊造成的可視性缺口
面對新威脅,企業的直覺往往是「再導入一個產品」:SD-WAN、VPN、CASB、DLP,如今又多了一套 AI 安全工具,各自擁有獨立的主控台、政策與日誌。結果是告警分散,一筆異常登入、一筆大量下載、一句可疑提示詞,若未在同一個脈絡中關聯分析,就可能各自被判定為低風險。在攻擊以小時計的時代,破碎的可視性正是攻擊者最大的機會。
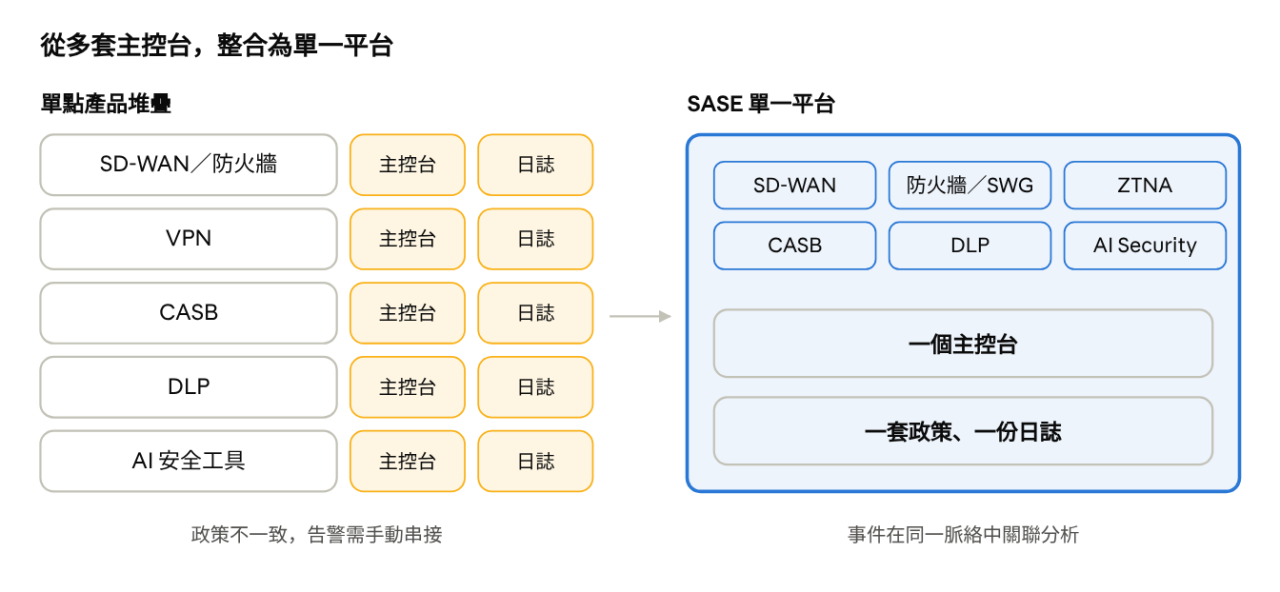 圖五:單點產品堆疊與 SASE 單一平台的管理架構對比。
重新思考防禦架構:平台化、零信任與 AI 治理
因此,後 AI 時代的防禦架構應以「以 AI 對抗 AI」為前提,可從以下方向著手:
- AI 使用治理:先看見員工實際使用的 AI 服務,再依資料分級決定允許、限制或禁止。
- 零信任延伸至 AI:人、裝置與 AI Agent 皆以最小權限授權,並持續驗證。
- 語意層檢測:在資料送入模型前即時檢查,並為自建 AI 應用提供執行階段(Runtime)防護。
- 整合平台與 AI 驅動回應:以單一平台整合網路與資安,讓防禦端同樣能自動關聯事件、快速緩解新漏洞。
其中整合平台是其他方向的基礎,也就是安全存取服務邊緣(Secure Access Service Edge, SASE)的核心概念:當所有流量都經過同一個平台,AI 才有完整的資料可供判斷。
Cato Networks:將 AI 安全原生融入 SASE 平台
上述防禦思維並非紙上談兵,茂綸所代理的資安解決方案 Cato Networks 正是將這些概念落實為單一平台的代表。Cato SASE Cloud Platform 建置於自有的全球私有骨幹網路,擁有超過 100 個服務節點(Point of Presence, PoP),所有連線皆在最近的 PoP 由 Cato SPACE 安全引擎一次完成檢查,並涵蓋 SD-WAN、SSE、Universal ZTNA 與 AI Security 等模組,企業可依需求逐步導入。
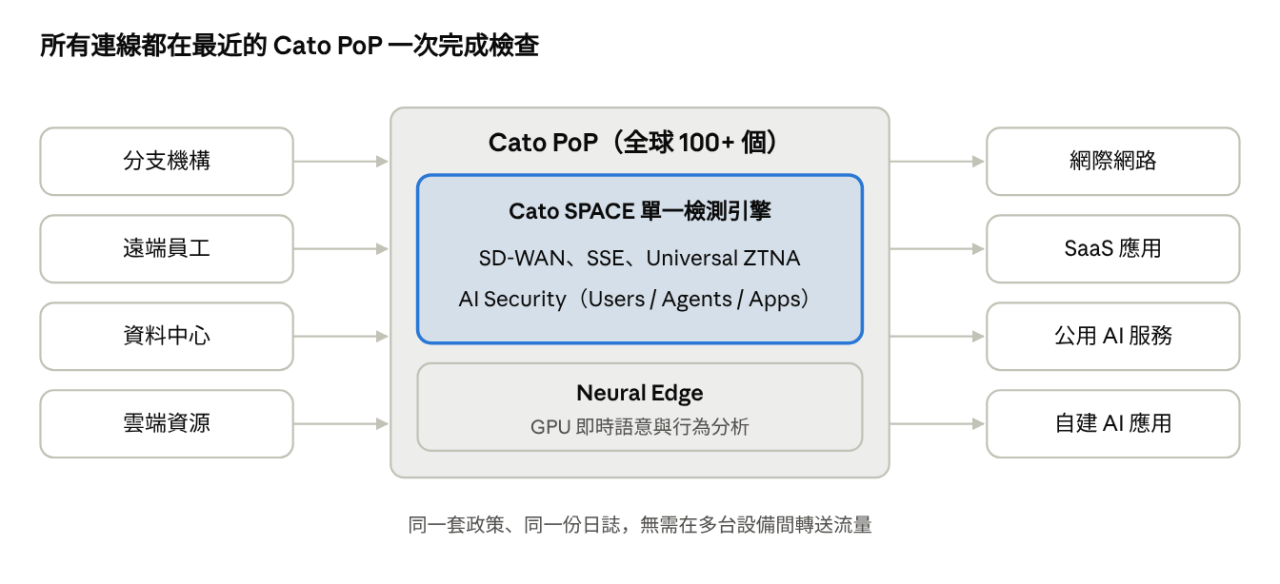 圖六:Cato SASE Cloud Platform 架構示意圖,各類連線皆於最近的 PoP 中由單一引擎完成檢查。
Cato AI Security:涵蓋使用者、Agent 與應用程式
Cato AI Security 將 AI 治理與執行階段防護納入同一個政策引擎,以語意分析(Semantic Analysis)判讀提示詞與回應的意圖,並依保護對象分為三大維度:
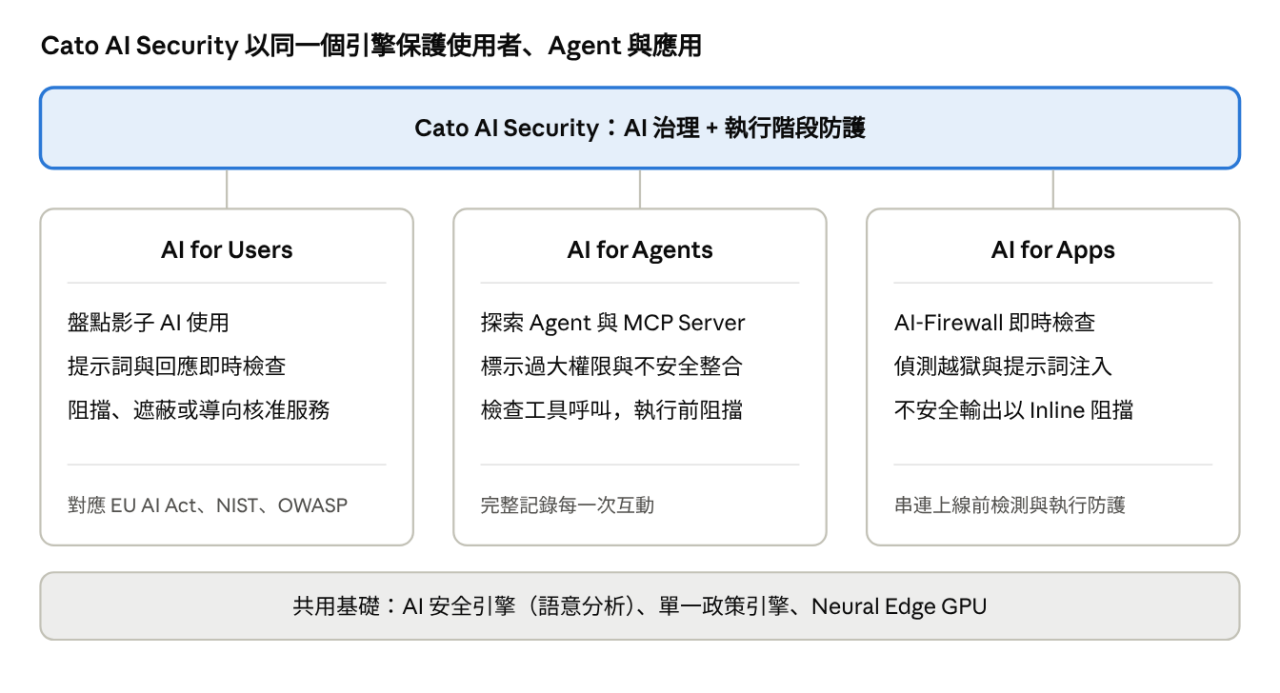 圖七:Cato AI Security 的三大方向:AI for Users、AI for Agents 與 AI for Apps。
- AI for Users:免安裝端點代理程式即可盤點員工使用的 AI 工具、揭露影子 AI,並在提示詞送出當下阻擋或遮蔽(Redact)敏感內容。
- AI for Agents:探索 Agent 所使用的工具與 MCP Server,檢查完整的動作鏈,在高風險動作執行前加以阻擋,並留下可稽核的操作軌跡。
- AI for Apps:以 AI-Firewall 即時偵測自建 AI 應用遭受的越獄(Jailbreak)與提示詞注入,在不安全的輸出到達使用者前加以攔截。
此外,Cato Neural Edge 在骨幹網路中部署 NVIDIA GPU,讓 AI 檢測直接在 PoP 內完成,無需將流量外送。
總結:以 AI 對抗 AI 攻擊
當攻擊者也擁有 AI,資安的關鍵就不再是多部署一台設備,而是能否在同一個平台上看見所有使用者、應用與 AI 的行為,並以與攻擊者相同的速度做出回應。針對 AI 加速的攻擊,Cato 於 2026 年推出 Agentic CVE Mitigation,對新公開的漏洞最快可在 45 分鐘內套用防護;以及 Agentic Threat Prevention,以自主 Agent 預測攻擊者可能的路徑,並在所有 PoP 同步執行防護政策(透過 Cato 全球私有骨幹網路)。正如 Cato 執行長 Shlomo Kramer 所說:「預測就是新的防禦(Prediction is the new prevention)。」
茂綸(Macnica Galaxy Inc.)所代理的 Cato Networks 針對分支機構互聯(SD-WAN)、遠端存取(Remote Access)、雲端應用安全(CASB / DLP)與 AI 使用治理(AI Security)提供全方位的解決方案。透過網路與資安的持續融合與 AI 驅動的威脅防禦,打造出更即時、更全面且易於管理的安全架構,協助企業安心釋放 AI 的無限潛能。
參考文獻與資料來源
- [1] IBM Security / Help Net Security:Cost of a Data Breach Report 2025(2025 年資料外洩成本報告) https://helpnetsecurity.com/2025/08/04/ibm-cost-data-breach-report-2025
- [2] Anthropic:Disrupting AI Espionage: Defending Against State-Sponsored AI Cyber Operations(反制 AI 國家級間諜行動報告) https://www.anthropic.com/news/disrupting-AI-espionage
- [3] OWASP Top 10 for LLM Applications:LLM01 - Prompt Injection(提示詞注入攻擊防禦指引) https://genai.owasp.org/llmrisk/llm01-prompt-injection/
- [4] PR Newswire / Cato Networks:Cato Networks Acquires AIM Security to Extend SASE Leadership and Secure Enterprise AI Transformation https://www.prnewswire.com/news-releases/cato-networks-acquires-aim-security-to-extend-sase-leadership-and-secure-enterprise-ai-transformation-302543642.html
- [5] Cato Networks 官方公告:Cato Introduces First GPU-Powered SASE Platform with Native AI Security(業界首款 GPU 原生 SASE 平台) https://www.catonetworks.com/news/cato-introduces-first-gpu-powered-sase-platform-with-native-ai-security/
- [6] SiliconANGLE:Cato Networks Launches Agentic Threat Prevention to Counter AI-Assisted Attacks https://siliconangle.com/2026/08/03/cato-networks-launches-agentic-threat-prevention-counter-ai-assisted-attacks/
- [7] Cato Networks 架構白皮書:Cato Global Private Backbone Architecture & SLA(全球私有骨幹網路架構) https://www.catonetworks.com/platform/global-private-backbone/
- [8] Cato Networks 官方方案:Cato AI Security for End Users(終端使用者 AI 應用治理與防護) https://www.catonetworks.com/platform/ai-security-for-end-users/
- [9] Cato Networks 官方方案:Cato Agentic AI Security(自主 AI 代理與 MCP 工具鏈安全治理) https://www.catonetworks.com/platform/agentic-ai-security/
- [10] Cato Networks 官方方案:Cato AI Security for Applications(企業自建 AI 應用與防火牆防護) https://www.catonetworks.com/platform/ai-security-for-applications/
You may also want to know